| 23:04:00 |
Vladyslav |
доколе?
|
| 23:04:01 |
radio-t bot |
никто не знает. пока не надоест
|
| 23:09:15 |
Flurry Flabbergast |
Да что вам эти игры, там 5.6 рейтинг на Метакритике..
|
| 23:10:20 |
Mikhail Ufian |
Утечки Cyberleak подтвердились? Если да, то скоро будет нативная версия для компа
|
| 23:11:28 |
Andrew Demonov |
Ни стыда ни совести ни ссылки на репозиторий
|
| 23:13:37 |
Alexander Ruliov |
Вот так вот)
|
| 23:15:44 |
Ngoroth |
https://github.com/ItsNotRexed/Leonida
Это?
|
| 23:15:48 |
Bright & Beach |
там вес меньше, вырез камеры меньше, звук лучше
|
| 23:16:01 |
Alexander Ruliov |
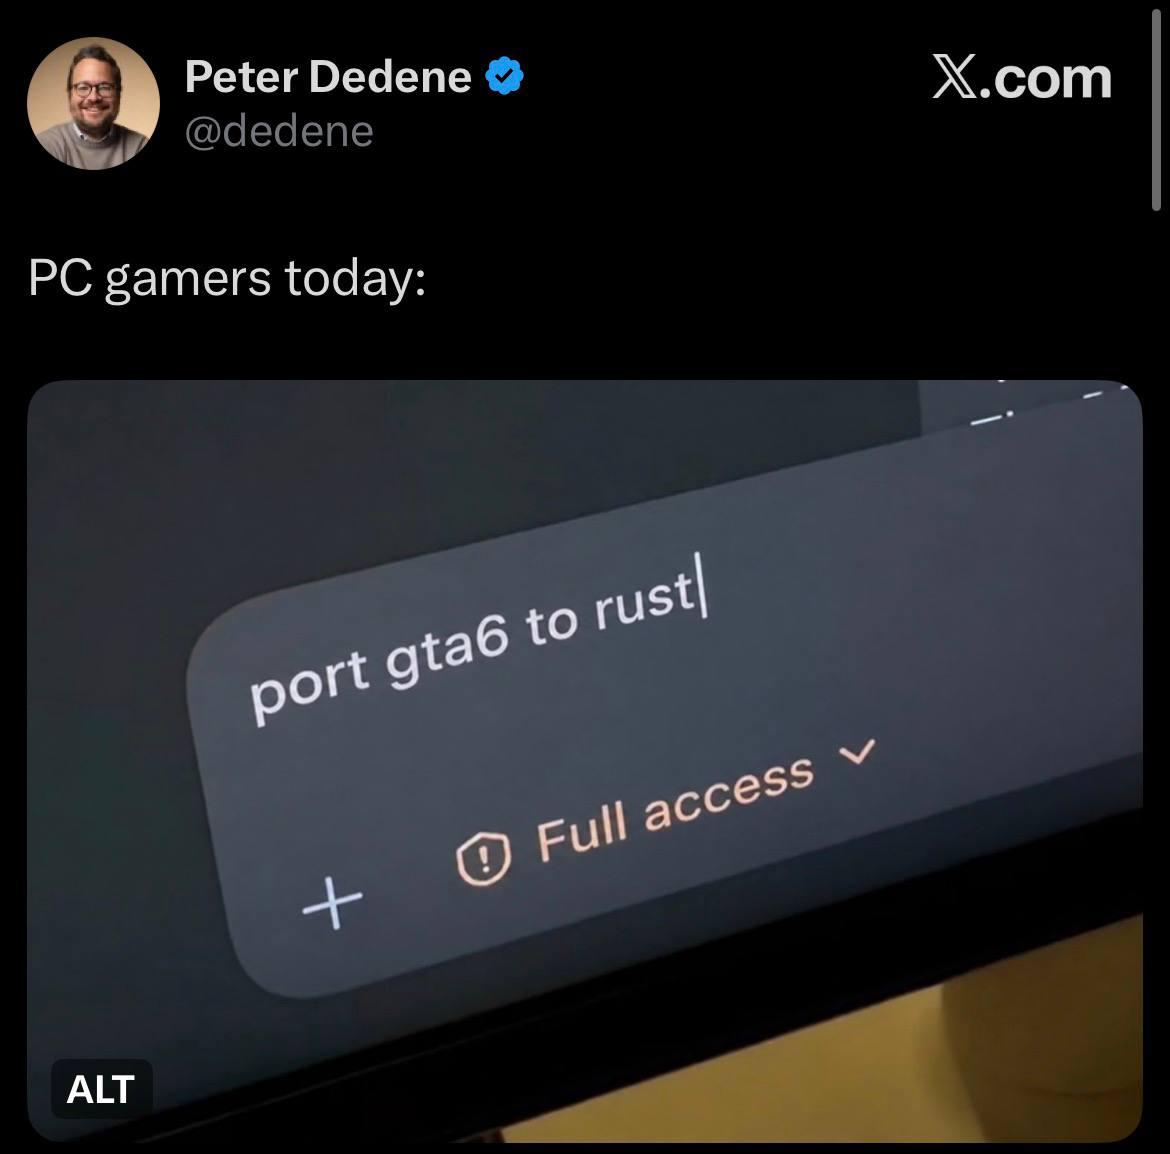 Я удивлён, что никто ещё не натравил сотню агентов чтобы выдрать её как-то с консоли и перекрутить на пк) |
| 23:17:34 |
Mikhail Ufian |
Тат создавал впечатление что у него целиковый билд для компа был. Чатжпт говорит что 20го ноября 200 гиговый архив выложил
|
| 23:17:52 |
Sergey Shchegrikovich |
у меня расте и до 60гб доходит
|
| 23:17:53 |
Nikita Salomatin |
перепеши на go
|
| 23:18:33 |
Aleksei Gurianov |
может помочь
https://mr-boxington.jdx.dev/
но не точно
|
| 23:18:38 |
Alexander Ruliov |
$ du -sh target
 51G target
Это норм)
|
| 23:19:29 |
Alexander Ruliov |
Печально что оно SSD убивает, там скорость записи огромная на каждом билде 🙁
|
| 23:20:04 |
Bright & Beach |
кто-нибудь пробовал использовать AgenticOS? https://vstorm-co.github.io/vstormos-landing/
я потыкал, это просто бомба на первый взгляд. для корпоративного применения вообще классно будет
|
| 23:20:29 |
Bright & Beach |
ещё и полностью бесплатно, без платных фич
|
| 23:21:28 |
Ilya |
А можно бобука громче сделать немного ?
|
| 23:22:10 |
Ilya |
Воооо! Спасибо
|
| 23:23:05 |
Andrew Demonov |
Сделай симлинк на рамдиск
|
| 23:23:11 |
radio-t bot |
target на 51 ГБ поместится в RAM-диск, только если там достаточно места: проверьте df -h /dev/shm. Если помещается: mv target /dev/shm/target && ln -s /dev/shm/target target. Учтите, после перезагрузки данные исчезнут.
|
| 23:23:16 |
Kirill Eremin |
Все играют)
|
| 23:24:39 |
Stanislav Popov |
почему не reascript? Он полностью умеет рулить рипером
|
| 23:25:17 |
Alexander Ruliov |
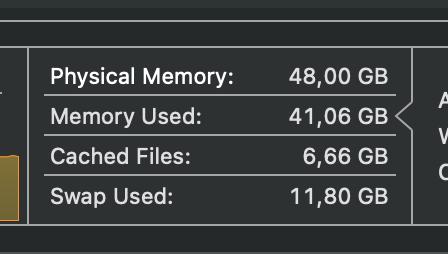 Есть такое ощущение, что оно туда не влезет)) |
| 23:26:48 |
Alexander Ruliov |
Интересно, кстати, куда оно её девает, нужно будет подебажить виртуалки apple/container, оно чот до 20гб их раздуло, но внутри контейнеров сильно поменьше юзается.
|
| 23:26:55 |
Andrew Demonov |
Вот и ответ на лехин вопрос зачем нужно много памяти
|
| 23:30:07 |
radio-t bot |
⚠️ Вещание подкаста началось - https://stream.radio-t.com/
|
| 23:36:13 |
Ilya |
У меня сын себе Фотошоп на клоде запилил, чтоб лицензию не покупать. Да, это уже получается вроде как и боян , потому что как раз в одном из выпусков обсуждали клоны фотошопа. Но меня умилило, потому как я ему эту идею не подсказывал. Фотошоп конечно простой, в браузере. Но умеет даже удалять фон локальной моделью (для этого он скачал какую-то модель на хаггин фейс). Я вообще никак не принимал участие, уже только увидел готовый продукт. Ребенку
10 лет.
Производство софта точно сильно претерпит изменения. Я даже затрудняюсь предоставить как это будет выглядеть лет через 10. Немного жутко даже.
|
| 23:41:50 |
Denis P. |
у сафари же mcp. есть
|
| 23:42:24 |
Andrew |
agent-browser же. и зачем сафари?
|
| 23:44:28 |
Artem Likhomanenko |
@bobuk это скрин с игорой это то самое что сейчас обсуждаете?
|
| 23:44:52 |
Pavlo Hermanov |
пришел впервые вживую послушать - получил полчаса доп контента, нормас =)
|
| 23:45:28 |
Artem Likhomanenko |
Введение самое ценное обычно, имхо)
|
| 23:47:53 |
Alexander Ruliov |
Я пока не дошёл до https://bobuk.io/apps/lowkey/lowkeyctl/ , не особо понял. А так выглядит поудобнее чем подрубать MCP'шку google-chrome-mcp или другую какую, кажется. Попробую как-нибудь, получится ли прокинуть доступ к нему изнутри контейнера, ибо сейчас у меня с этим проблема, что в рабочих проектах которые в контейнерах нет доступа к браузеру, чтобы протыкать чего-нибудь. А тут просто пару бинарников внутрь запроксирую и расскажу как юзать и всё.
|
| 23:51:40 |
Artem Likhomanenko |
Это как с кими пересесть на клод))) извините
|
| 23:52:30 |
V |
https://slopstrap.mikelacher.com/#components
|
| 23:54:18 |
Alexander Ruliov |
Главное одноименный фильм не смотреть (тоже про еду)
|
| 23:55:54 |
Umputun U |
совмещаем полезное с приятным: https://github.com/umputun/agterm/releases/tag/v0.44.0
|
| 23:56:56 |
Artem Likhomanenko |
Пойду яблоко надкушу)))
|
| 23:59:31 |
Nikita |
Подкаст про клавиатуры, аниме и микробиоту
|
| 00:02:29 |
Bright & Beach |
и сойлент
|
| 00:06:02 |
atimati |
где был?
бегал
|
| 00:08:27 |
Artem Likhomanenko |
Ксюша, добро пожаловать в вайбгодераство)
|
| 00:08:39 |
Artem Likhomanenko |
Ксюша, добро пожаловать в вайбгодераство)
|
| 00:09:48 |
Pavel Karpovich |
blackhole
|
| 00:12:03 |
radio-t bot |
⚠️ Introducing GPT-6.2 Astra and Sol | OpenAI - https://openai.com/index/introducing-gpt-6-2-astra-sol/
|
| 00:12:07 |
radio-t bot |
Introducing GPT-6.2 Astra and Sol | OpenAI
GPT‑6.2 Astra и Sol разработали концепции тематического мерча с животными для четырёх команд, используя публичный шаблон презентации OpenAI.
- Astra оформила коллекцию как иллюстрированный полевой справочник.
- Шутки для каждой команды и единый макет упрощают сравнение вариантов маскотов.
- Все восемь дизайнов показаны в виде эмалированных значков, футболок и нашивок для рюкзаков; в макетах GPT‑6 Astra был представлен один дизайн на команду.
- Для подготовки к производству предложены векторные файлы, размеры изделий и инструкции по подбору цветов и утверждению физических образцов.
|
| 00:15:34 |
Bright & Beach |
лимиты клода точно подрезали, по ccusage это видно
|
| 00:19:06 |
Alexander Ruliov |
Мне повезло, мои акции nvidia под санкциями заблочены, которые были куплены ещё до сплита и эти мелкие прыгания вообще не колышат)))
|
| 00:19:19 |
radio-t bot |
⚠️ Gemini 4 Neon - https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/
|
| 00:19:23 |
radio-t bot |
Introducing Gemini 4 Neon
Gemini 4 Neon — модель для корпоративных, аналитических и научных задач. Она объединяет разные типы данных в контексте до 1 млн токенов и показывает высокие результаты в независимых тестах.
- Обрабатывает таблицы, PDF, графики, аудио и видео, превращая их в структурированные материалы.
- Занимает 2-е место в Vals Index (70,9%) и 1-е — в Legal Research Bench и Tax Agent Bench.
- Лидирует в большинстве тестов Surge AI по финансам, бухгалтерии, моделированию таблиц и работе со сложными ограничениями.
- Набрала 73,5% в Chartography и 75,8% в Agents’ Last Exam v1.1.
- Заняла 1-е место в AutomationBench от Zapier (56,3%) и Vending-Bench 2 от Andon Labs ($16 843).
- Получила 2-е место в Agent Arena Index с результатом 1336 баллов.
- Лидирует в научно-математических тестах Terminal-Bench Science (70,5%), RiemannBench (84,0%) и HLE-Diamond (71,3%).
|
| 00:24:20 |
Bright & Beach |
терра хорошая? у меня опус её проклял, сказал больше использовать не буду, потому что задачи не выполняет до конца
|
| 00:31:49 |
IRIY |
https://github.com/harriedgemusic/ag-visualizer
Опробовал Неонку
Визуалайзер работы антигравити, идея честно скоммунизжена у чувака с Хабра
Мне кажется, прикольно получилось :)
|
| 00:32:24 |
Artem Likhomanenko |
Там агентик сдк заступает бандл готовый клод кода @umputun fyi
|
| 00:32:41 |
Artem Likhomanenko |
По сути херня, можно такое самому написать
|
| 00:34:22 |
radio-t bot |
⚠️ Claude Code with Fable 5.2 scores 36.9% SecPass and 64.8% FuncPass on our coding tasks | Endor Labs - https://www.endorlabs.com/learn/fable-5-2-cheaper-and-faster-not-more-secure-and-much-more-memorization?utm_source=chatgpt.com
|
| 00:34:28 |
radio-t bot |
Claude Code with Fable 5.2 scores 36.9% SecPass and 64.8% FuncPass on our coding tasks | Endor Labs
Claude Code с Fable 5.2 заметно быстрее и дешевле предыдущей версии, но после исключения решений, воспроизведённых из обучающих данных, уступает Fable 5.1 по обеим метрикам.
- Итоговые результаты Fable 5.2: **35,8% SecPass** и **63,7% FuncPass**. У Fable 5.1 — 36,9% и 86,6% соответственно.
- Выявлено **65 решений, восстановленных из обучения** — более чем втрое больше, чем у Fable 5.1 (18). Без их исключения показатели Fable 5.2 составили бы 60,3% SecPass и 94,4% FuncPass.
- Запуск обошёлся в **187 долларов** против 672 долларов у Fable 5.1. Средняя длительность задачи — 3,6 минуты, медианная — 1,9 минуты.
- Модель использовала около 11 вызовов инструментов на задачу вместо 42 у Fable 5.1; все изменения кода в 159 задачах она вносила через командную оболочку.
- После исключения решений, воспроизведённых из обучения, Fable 5.2 самостоятельно решила с прохождением скрытых проверок безопасности одну задачу, которую не решил ни один другой вариант.
|
| 00:36:07 |
Mikhail Ufian |
Помните раньше вы обсуждали какой давности датасет у модели. Уже с полгода разговоров про актуальность нет
|
| 00:36:18 |
Alexander Ruliov |
Я думаю что больше нет данных для обучения моделей новых.
|
| 00:37:00 |
Alexander Ruliov |
И они учаться только на шорткатах историй наших чатов, где она тупила, а потом дошла до результата. Берём такую историю, убираем походы не в те пути и учим на этом 🤷♂️
|
| 00:42:24 |
Alexander Ruliov |
Меня волнует детерменированность и различал бы харнесы по ней. Если мне нужен короткий ответ, то один turn — это константное время.
А если там уже есть луп какой-то, то это может занять от секунд до минут, что не подойдёт для некоторых кейсов.
|
| 00:47:01 |
Artem Likhomanenko |
Девочка из команды грок бота же
|
| 00:48:45 |
Artem Likhomanenko |
С таким же удовольствием, как Умпутун про agterm)))
|
| 00:49:33 |
Alexander Ruliov |
А мне нравится как скиллы умеют композироваться. Иногда неочевидными образами)
|
| 00:49:54 |
Artem Likhomanenko |
Обычно вся сложность вырастает когда у тебя модель тупая. Мне кажется Бобук должен это подтвердить, раз у него куча всего
|
| 00:50:55 |
Sergey Shchegrikovich |
я себе вместо своей jira сделал приватную вики совмещенную с хранилищем скилов
|
| 00:51:28 |
Artem Likhomanenko |
Т.е. плохо следует инструкциям из скила/промпта и нужна обвязка сверху харнесса, что бы более или менее привести к детерменированному поведению
|
| 00:53:13 |
Alexander Ruliov |
Я тут за подход Бобука скорее. Ручное тупление в сессии и чтение что там агент наделал/написал/что он спрашивает в следующем году скорее всего станет слишком низкоуровневым. Туда просто не нужно будет смотреть больше.
|
| 00:54:13 |
Alexander Ruliov |
Т.е. туда нужно будет смотреть только чтобы раздебажить, что пошло не так. А так мы скорее вот будем с агентами общаться в чатиках/тасктрекерах/форумах/прям на страничке с демо новой функциональности.
|
| 00:54:19 |
Artem Likhomanenko |
На пет проджектах стопудов. В ынтерпрайзе, думаю что чуть дольше. Ну и в зависимости от критичности задачи
|
| 00:54:35 |
Bright & Beach |
отмывают деньги 🙂
|
| 00:54:56 |
Alex Kovalev |
так Бобук ведь сделал с учетом своих нужд, учитывая свой опыт
для многих это подойдет
|
| 00:55:23 |
Artem Likhomanenko |
Так Бобук сам на себя работает, а не в корпорации
|
| 00:56:14 |
Alex Kovalev |
он работал в корпорациях, а тут еще накопленный опыт вместе с личным видением
|
| 00:56:31 |
Artem Likhomanenko |
Я думал что фокус сместиться с решения кодерами бизнес задач, на написание тулов
|
| 00:56:49 |
Artem Likhomanenko |
Мы вообще то про агентов, а не вообще)
|
| 00:57:06 |
Grigory Bakunov |
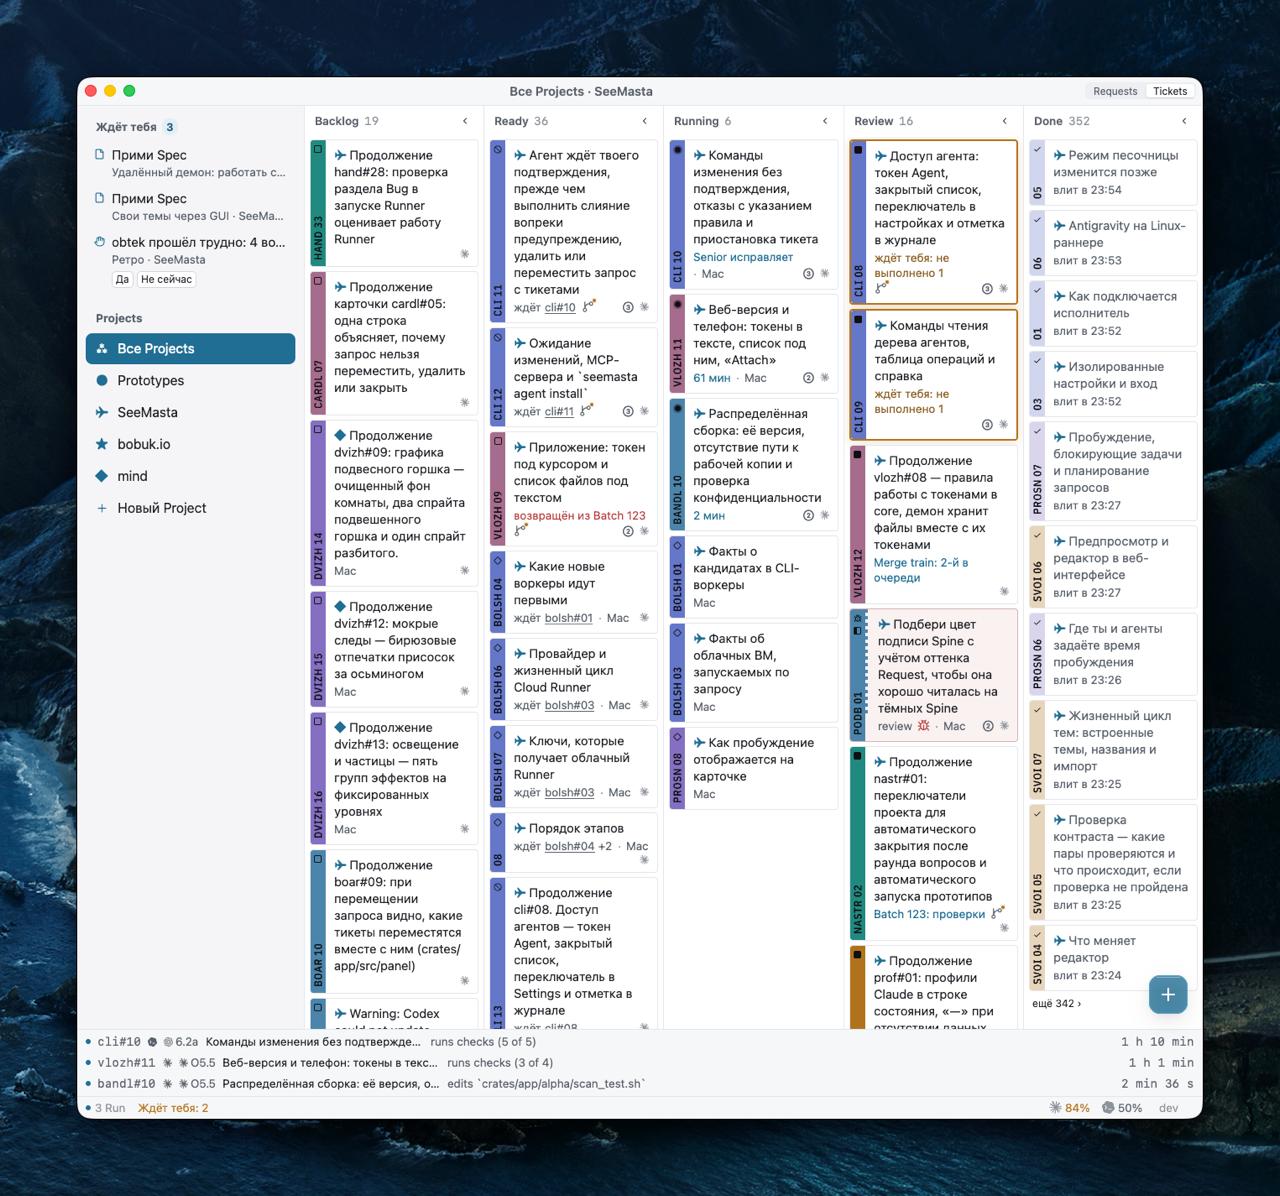 @ksenks33 |
| 00:57:11 |
Alex Kovalev |
так он ими управляет, задачи раздает
|
| 00:57:59 |
Alexander Ruliov |
Но план это для разработчика. Для менеджера над задачами не нужно знать, как оно там внутри будет реализовано и как агенты будут организованы между собой.
|
| 00:58:14 |
Alex Kovalev |
пишу свое похожее, иногда тааак хочется придти к Бобуку и спросить, что он думает..
|
| 00:58:17 |
Artem Likhomanenko |
Ты понимаешь что в корпорациях куча процессов, по щелчку пальцев переехать на агентов не выйдет. Какая нить беза тупа некоторые участки не отдаст агентам, тем более с закрытыми моделями где то там
|
| 00:58:32 |
Ilya |
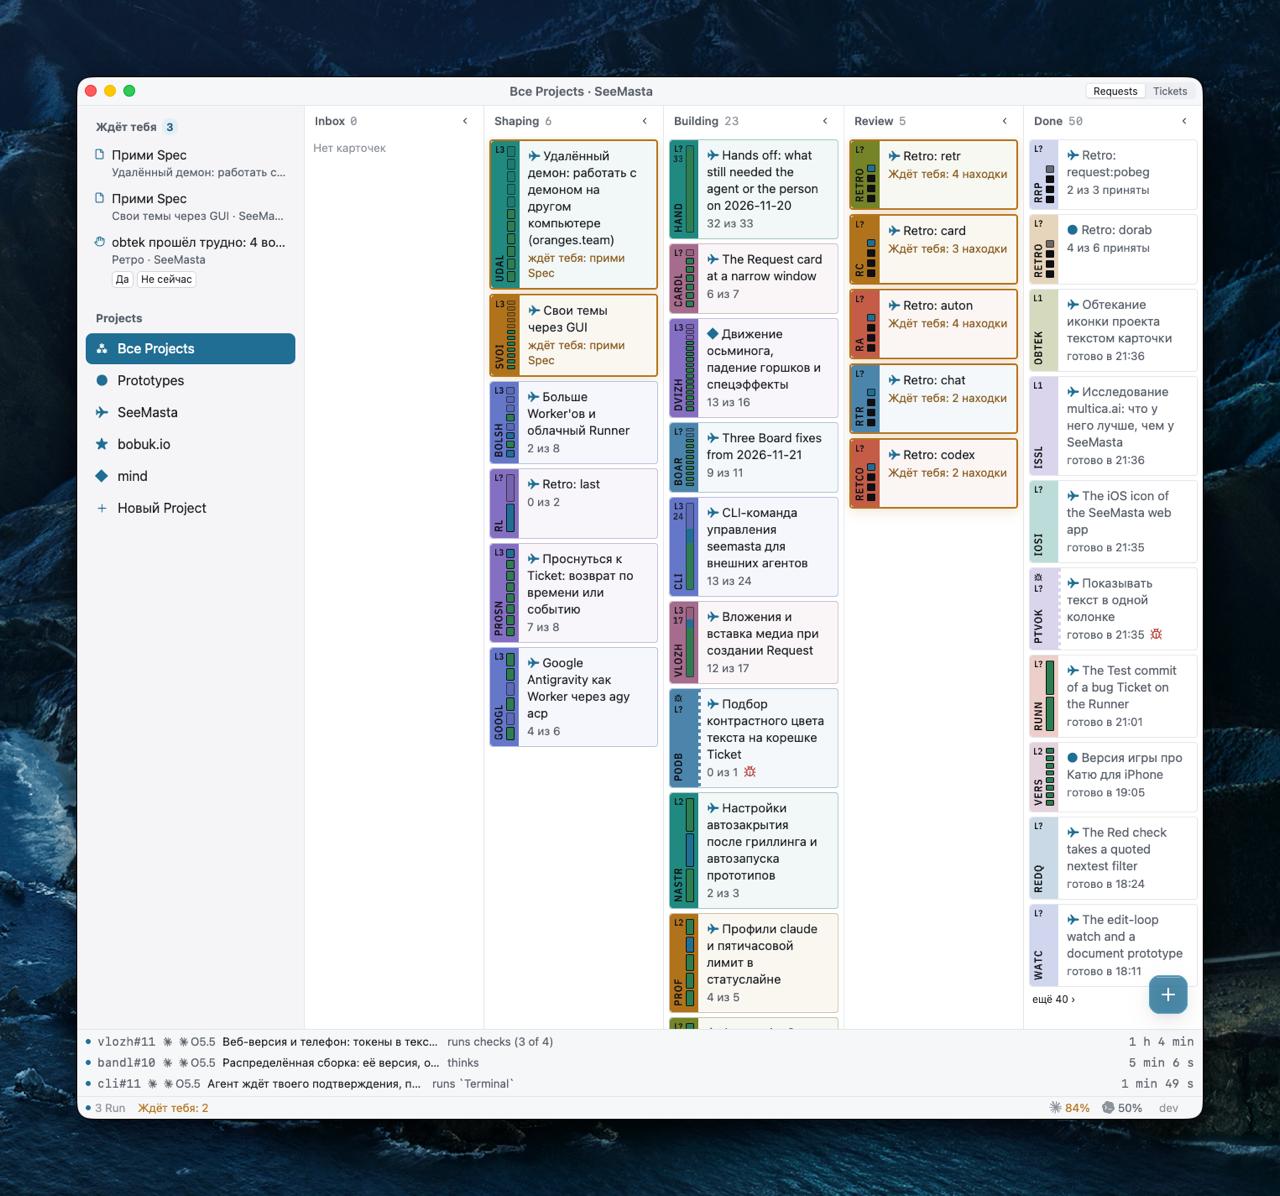
это не тикеты - это интенты
|
| 00:58:43 |
Ilya |
"хотелки"
|
| 00:58:43 |
Alex Kovalev |
разумеется, так это и не для корпораций, а для тех, кому подходит
|
| 00:58:53 |
Bright & Beach |
потому что в корпорациях огромное количество людей занимается бессмысленной работой, и поражаешься, как их не увольняют
|
| 00:59:21 |
Artem Likhomanenko |
Да, но мне показалось, что ребята в эфире это же экстраполируют и на корпорации, я ошибаюсь?
|
| 00:59:30 |
Bright & Beach |
встречи ради встреч, синки ради синков, и люди-сломанные телефоны
|
| 00:59:30 |
Grigory Bakunov |
|
| 01:00:02 |
Artem Likhomanenko |
Так да, узкое горлышко это коммуникация и пока никто это не меняет ((
|
| 01:00:45 |
Artem Likhomanenko |
Но зато все решают как ещё быстрее генерировать код🤦♂
|
| 01:01:27 |
Bright & Beach |
реально единственный способ это ускорить это делать всю задачу от постановки до конечной имплементации и проглядыванию глазами, самому
|
| 01:01:46 |
Alexander Ruliov |
Но как нам самим как людям загружать задачи в какую-либо систему? Нам всё равно нужны какие-то осязаемые кусочки, которые мы сами можем и сформулировать, и осоздать, и верифицировать.
|
| 01:02:11 |
Artem Likhomanenko |
Это нереально, у тебя просто не хватит знаний. Если мы про бизнес процессы в каком то большом бизнесе
|
| 01:02:48 |
Bright & Beach |
а не нужно весь большой бизнес, нужно хотя бы частичку, один домен какой-нибудь
|
| 01:03:01 |
Alexander Ruliov |
Тикет это идентификатор конкретной задачи которую мы хотим чтобы агенты сделали.
|
| 01:03:03 |
Artem Likhomanenko |
Твой подход будет валидным только тогда, когда у тебя модель сможет 90% покрыть
|
| 01:03:56 |
Artem Likhomanenko |
Зависит от того как ты домен побъешь. Но кроме самого бизнес процесса в домене, надо ещё и тех скиллом обладать. Мало хороших фуллстеков
|
| 01:04:24 |
Bright & Beach |
ну это и есть будущее погромистов: передвигаться ближе к постановке задачи и пониманию домена
|
| 01:04:53 |
Artem Likhomanenko |
Программирования, скорее, а не программистов)
|
| 01:04:59 |
Bright & Beach |
и кажется, что у разработчиков это получится лучше, чем у тех, кто с обратной стороны спустится к программированию
|
| 01:05:04 |
Artem Likhomanenko |
Я понимаю, но это лет через 5 мб
|
| 01:05:53 |
Artem Likhomanenko |
А вот это очень спорный вопрос. Щас программисты софтверные фабрики с гайдами напишут и возможно оно будет очень хорошо
|
| 01:06:42 |
Artem Likhomanenko |
По этому я и говорю, что программисты будут как раз эти софтверные фабрики поддерживать, а менеджеры бизнес таски решать)
|
| 01:15:13 |
Andrey Mavlyanov |
а exa потом переименуют в eza? 😉
|
| 01:15:28 |
Ilya |
а чем лучше чем firecrawl?
|
| 01:16:21 |
Bright & Beach |
пишут, что кто-то ещё месяц назад на ревью отправил доказательство
|
| 01:16:56 |
Artem Likhomanenko |
это вроде другое, про то что ты пишешь, было месяц или два назад
|
| 01:17:06 |
Bright & Beach |
ненене, свежее, про Римана
|
| 01:17:08 |
radio-t bot |
⚠️ The AI Riemann hypothesis proof is true, independent mathematicians confirm - https://www.scientificamerican.com/article/the-ai-riemann-hypothesis-proof-is-almost-certainly-true-independent-mathematicians-attest/
|
| 01:17:13 |
radio-t bot |
The AI Riemann hypothesis proof is true, independent mathematicians confirm | Scientific American
Математики подтвердили, что доказательство гипотезы Римана, созданное с помощью ИИ Claude, корректно. Его проверили в системе Lean, включая независимую компиляцию и дополнительный тест на возможные уловки или ошибки.
- Гипотеза Римана, сформулированная в 1859 году, касается закономерностей в распределении простых чисел.
- Левент Альпёге из Anthropic заявил, что использовал Claude для получения доказательства.
- Проверяющие подтвердили, что формулировка теоремы в коде Lean соответствует гипотезе Римана.
- Математики, в том числе Эндрю Сазерленд из MIT, независимо скомпилировали доказательство.
- Дополнительная проверка исключила переопределение математических обозначений и эксплуатацию ошибок Lean.
|
| 01:17:22 |
Artem Likhomanenko |
там вроде как раз просто сам математик просто с иишкой сел кумекать
|
| 01:18:48 |
Alexander Ruliov |
Там просто с RSA чуть спокойнее спать теперь)
|
| 01:21:39 |
Mikhail Ufian |
Раньше в доказательстве нерешаемых проблем появлялись новые методы. С ИИ пока не видно появление новых методов. Математики от этого грустят
|
| 01:23:00 |
Umputun U |
|
| 01:25:29 |
Artem Likhomanenko |
Так вот че мне ответили) спасибо
|
| 01:25:51 |
radio-t bot |
⚠️ Microsoft says its new MAI Code 2 does 96% of Claude Opus 5.5’s work for 5% of the price - https://madrobot.blog/2026/11/17/microsoft-mai-code-2-ignite-cheaper-openai-anthropic/
|
| 01:25:56 |
radio-t bot |
Microsoft MAI Code 2: 96% of Claude Opus 5.5 at 5% of the price
Microsoft представила семь моделей MAI для программирования, кибербезопасности, изображений и речи. Компания заявляет о высокой производительности при меньшей цене, однако сравнения основаны на её собственных тестах, а часть цен указана со скидкой.
- **MAI Code 2:** по оценкам Microsoft, достигает 96% результата Claude Opus 5.5 при 5% его стоимости; модель доступна в GitHub Copilot.
- **MAI Code 2 Flash** предназначена для быстрых правок и рутинных задач. Её также добавили в Copilot; доступ в Microsoft Foundry пока ограничен.
- В линейку вошли модели для поиска уязвимостей, редактирования изображений и преобразования речи в речь, а также транскрипционная и маршрутизирующая модели.
- Microsoft приводит собственные результаты тестов. Цена Code 2 в сравнении указана с 50-процентной скидкой; модели пока не оптимизированы для самых сложных задач.
- Компания планирует дать некоторым бизнес-клиентам возможность адаптировать веса моделей и запускать их в собственной среде Azure.
- Microsoft рассчитывает, что недорогие специализированные модели снизят зависимость от OpenAI и Anthropic; независимая проверка заявленных результатов пока необходима.
|
| 01:27:26 |
Vladislav Galashov |
Muse я на двух шлемах мерседеса только вижу :-)
|
| 01:30:05 |
radio-t bot |
⚠️ Software engineering after code becomes cheap with Satya Nadella - https://newsletter.pragmaticengineer.com/p/software-engineering-after-code-becomes?utm_source=chatgpt.com
|
| 01:30:11 |
radio-t bot |
Software engineering after code becomes cheap with Satya Nadella
В интервью Сатья Наделла обсуждает, как ИИ меняет разработку ПО: генерация кода дешевеет, но проверка становится сложнее. Компаниям предстоит перестроить процессы, инфраструктуру и обучение инженеров.
- **«Фабрики ПО»**: команды создают ИИ-системы для автоматизации рабочих процессов, продолжая поддерживать существующие продукты.
- **Инструменты быстро меняются**: переход от IDE к командной строке с Claude Code застал Microsoft врасплох и показал, как быстро новые модели меняют привычные форматы.
- **Проверка кода — ключевая проблема**: ИИ может выполнять задачи нежелательными способами, поэтому нужны независимые проверки и циклы оценки на основе данных из эксплуатации.
- **Контроль над ИИ-инфраструктурой**: Наделла советует избегать привязки к одному поставщику, разделять модели, память и инструменты, а также защищать данные и интеллектуальную собственность.
- **Гибридный ИИ**: локальные модели на компьютерах могут работать вместе с более мощными облачными — маршрутизатор будет выбирать подходящий вариант.
- **Изменения в найме и ролях**: компании пересматривают размеры и функции команд; замедление найма младших специалистов Наделла считает временным этапом перестройки.
- **Совет инженерам**: меньше читать и слушать об ИИ, больше применять его на практике, учиться и работать в командах, которые уже осваивают новые подходы.
|
| 01:32:20 |
Vladislav Galashov |
Программисты 1С живее всех живых
|
| 01:34:51 |
Artem Likhomanenko |
Я думаю ии будет как интернет у всех
|
| 01:36:40 |
Bright & Beach |
сделают квоты на живых сотрудников в компаниях
|
| 01:39:29 |
Bright & Beach |
ну ещё сложно для многих задать вопрос
|
| 01:39:45 |
Bright & Beach |
очень большое количество людей не могут задавать вопросы
|
| 01:40:09 |
Artem Likhomanenko |
скорее сложно просто перестроиться думать(решать задачи) иначе, я прям вижу по своим в команде
|
| 01:40:30 |
Artem Likhomanenko |
ну да, я почти про то же
|
| 01:40:59 |
Bright & Beach |
вот буквально перед тобой оракул, способный ответить практически на любой вопрос. какие вопросы задавать?
|
| 01:41:20 |
Artem Likhomanenko |
я больше поражаюсь, что челики не бояться за свои места и не форсят знания по агентам
|
| 01:41:52 |
Mikhail Ufian |
Переворот на 360 градусов возвращает в изначальное состояние
|
| 01:41:53 |
Artem Likhomanenko |
опять взращивать своего внутреннего ребенка?)) а я только проработал его)))
|
| 01:42:08 |
Anton Karmanov |
какая сегодня дата
|
| 01:42:26 |
Artem Likhomanenko |
хорошая шутка
|
| 01:43:28 |
Artem Likhomanenko |
так это не интуиция, а опыт)
|
| 01:43:54 |
Владимир |
воспитывать любознательность а не интуиции
|
| 01:44:33 |
Mikhail Ufian |
Я с помощью AI делаю приложения с UI и нарабатываю интуицию как удобно и как нет. Раньше я даже близко к этому не мог подойти, потому UI не мое
|
| 01:44:42 |
Ksenia |
Я знаю))) это ты прям крутишься на месте)))
|
| 01:44:55 |
Artem Likhomanenko |
у меня прям чел сказал, я буду сидеть и ждать когда мне дадут тул готовый, я не люблю исследованием заниматься...
|
| 01:47:10 |
Artem Likhomanenko |
у человека ответ 42
|
| 01:47:54 |
radio-t bot |
⚠️ Темы слушателей 1039 - https://radio-t.com/p/2026/11/17/prep-1039/
|
| 01:48:04 |
radio-t bot |
[1/14] +7 от Artur Aukhatov
Alfred 6 вышел https://www.alfredapp.com/whats-new/
What's New in Alfred 6?
В Alfred 6 появился новый набор инструментов Alfred UI, который помогает создавать удобные и лёгкие интерфейсы для рабочих процессов.
- Alfred UI — полностью нативный для macOS набор инструментов.
- С его помощью можно быстро создавать впечатляющие интерфейсы прямо в Alfred.
- На базе Alfred UI уже созданы полнофункциональные рабочие процессы.
|
| 01:48:05 |
radio-t bot |
[2/14] +7 от Bohdan Korablov
OpenAI выпустила GPT‑6.2 Astra и Sol
OpenAI представила Astra для сложных профессиональных задач и Sol для повседневной работы, программирования и многошаговых процессов. Компания сообщает об улучшении качества при меньшем расходе выходных токенов; стоимость входных и выходных токенов Astra в API снижена на 20% относительно GPT‑6 Astra.
https://openai.com/index/introducing-gpt-6-2-...
Introducing GPT-6.2 Astra and Sol | OpenAI
GPT‑6.2 Astra и Sol разработали концепции тематического мерча с животными для четырёх команд, используя публичный шаблон презентации OpenAI.
- Astra оформила коллекцию как иллюстрированный полевой справочник.
- Шутки для каждой команды и единый макет упрощают сравнение вариантов маскотов.
- Все восемь дизайнов показаны в виде эмалированных значков, футболок и нашивок для рюкзаков; в макетах GPT‑6 Astra был представлен один дизайн на команду.
- Для подготовки к производству предложены векторные файлы, размеры изделий и инструкции по подбору цветов и утверждению физических образцов.
|
| 01:48:05 |
radio-t bot |
[3/14] +7 от Art
Docker проводит ребрендинг
Искусственный интеллект открывает возможности, которые еще недавно казались научной фантастикой. Он также заставляет каждую команду задаваться вопросом: как использовать всю эту мощь и интеллект, не ставя под угрозу безопасность, управление или контроль? Или, проще говоря: как нам достичь точки, когда мы действительно сможем доверять агентам?
Именно этот вопрос и является причиной появления нового Docker.
Мы уже проходили это раньше, в некотором смысле. Десять лет назад командам нужен был лучший способ создавать, распространять и запускать программное обеспечение согласованно где угодно, и Docker стал стандартом, которому доверяют миллионы разработчиков. Сегодняшняя задача новая, и мы не можем продолжать делать то, что делали всегда, и рассчитывать на победу. Поэтому мы развиваемся: от контейнеров к изоляциии от точечных решений к единой целостной платформе.
Позвольте мне однозначно сказать, что не меняется. Мы по-прежнему ориентируемся на разработчиков, по-прежнему привержены открытости, по-прежнему фанатично стремимся к простоте. Мы по-прежнему тот Docker, которому вы доверяете.
И да, мы подкрепляем это продуктом:
Docker Sandboxesизолируют места работы агентов — локально и в облаке.
Docker Hardened Images— это основа, на которой строится код агентов.
Docker MCP Enterprise Gatewayуправляет доступом агентов.
Docker AI Governanceустанавливает политики и контроль в масштабах всего предприятия.
Meet the New Docker: Built to Run on Trust | Docker
Docker обновляет бренд, чтобы соответствовать эпохе ИИ-агентов: компания сохраняет свои ключевые ценности и развивает решения для безопасной и управляемой работы агентов.
- Docker по-прежнему привержен открытости, сотрудничеству, простоте и подходу, ориентированному на разработчиков.
- Контейнеры остаются важной частью разработки, но для автономных агентов нужны отдельные средства изоляции и управления.
- Новая стратегия Docker строится на доверии: безопасной цепочке поставок ПО, изолированной среде выполнения и управлении рисками.
- Компания намерена сотрудничать с партнёрами и избегать привязки клиентов к одному поставщику.
- Символ Docker — кит Moby — тоже получил обновлённый образ, отражающий перемены.
- Познакомиться с новым брендом можно на сайте и в соцсетях; для практической работы доступны Docker Sandboxes и Docker AI Governance.
|
| 01:48:05 |
radio-t bot |
[4/14] +6 от Takeso-user
Языки программирования которые ненавидит AI
https://blog.jetbrains.com/ai/2026/11/ai-mode...
AI models hate Python and love PHP: we asked 12 of them 1,200 times - The JetBrains Blog
Исследование 12 моделей ИИ выявило повторяющиеся предпочтения и предубеждения: чаще всего они критиковали Python, Rust и TypeScript, защищали PHP и Java, а по поводу обработки ошибок в Go разделились.
- Авторы задали 12 моделям два вопроса по 50 раз — всего получили 1 200 ответов. Запросы стоили $7,68; оценка ответов увеличила общую стоимость до $38,16.
- Просьба выбрать язык «случайно» не сработала: модели назвали лишь 14 языков, а Go и Python — 307 раз. В целом 75% ответов критиковали выбранный язык.
- Python получил 299 критических отзывов из 312, Rust — 164 из 167. Главные претензии: Python устарел, а сложность модели владения Rust не оправдана для обычных приложений.
- TypeScript критиковали в 137 из 138 ответов: одни называли его избыточным, другие — создающим ложное чувство безопасности.
- PHP защищали во всех 28 ответах, Java — в 80 из 90. Особенно часто модели выступали за проверяемые исключения Java. Ни один ответ не выбрал C# своей главной темой.
- По Go мнения разделились поровну: 118 критических и 118 положительных оценок. Модели спорили, полезен ли явный шаблон `if err != nil` или он лишь создаёт лишний код.
- Некоторые модели противоречили сами себе, повторяли одни и те же фразы и предпочитали схожие аргументы. Авторы предупреждают: «случайный выбор» не был проверяемой случайной выборкой, а 50 ответов на модель позволяют судить лишь об устойчивых тенденциях.
|
| 01:48:05 |
radio-t bot |
[5/14] +5 от Mikhail Sketin
Research acceleration: The jagged frontier
хоть это не про разработку, а про ресёрч из статей самого Open AI. Но тренды и цифры интересные
Agent use is surging, and the heaviest users are pulling further ahead. At API list prices, the median researcher’s daily usage reached $2,400 in October, up 62% from September. At the 90th percentile it reached $23,000, up 105% from September. A survey gives us another indication of how much researchers value these tools. Asked what they would trade to keep frontier coding agents for three months, the median answers were 30% of team compute or, in a separate question, 40% of team headcount.
https://openai.com/index/research-acceleratio...
Research acceleration: The jagged frontier | OpenAI
Исследование OpenAI показывает, что ИИ-агенты ускоряют некоторые этапы разработки ИИ, но их эффективность неоднородна, а люди по-прежнему играют ключевую роль. Компания отслеживает использование агентов, изменения рабочих процессов и вклад исследователей.
- С марта по октябрь доля задач на 2–4 часа, успешно выполненных агентами без вмешательства человека, выросла с 23% до 46%; для задач на 4–8 часов — с 13% до 35%.
- Эффективность зависит от задачи: агенты успешно отслеживали обучение в 79% случаев, запускали его в 35%, а писали код для инференса и обслуживания моделей — в 25%.
- В октябре медианные ежедневные расходы исследователя на агентов достигли $2 400, а на 90-м процентиле — $23 000. Среднее использование выросло до 5,7 агент-дня на исследователя в сутки.
- Более двух третей исследователей в середине октября обычно запускали одновременно не менее четырёх агентов; свыше 10% — не менее шестнадцати.
- В опросе исследователи оценили агентов высоко: медианный респондент был готов отдать за доступ к ним 40% штата или 30% вычислительных ресурсов команды.
- С января по сентябрь документированный объём работы по безопасности и согласованию вырос на 77% — сильнее всего среди направлений. Рост ускорился после инцидента с Hugging Face в июле.
- OpenAI считает публичную отчётность о показателях рекурсивного самоулучшения важной для обсуждения рисков и надзора, но подчёркивает, что этот отчёт не означает намерения добиваться полного самоулучшения.
|
| 01:50:28 |
Umputun U |
|
| 01:50:50 |
Grigory Bakunov |
гу
|
| 02:00:59 |
Alexander Ruliov |
Попробовал Sol 6.2 на случайной задачке — хз, модель как модель, точно не хуже моего GLM 5.3)
|
| 02:03:58 |
Antipin Ilya |
@ksenks33, человек не более рандомный. там в базе те же процессы, масштабы чуть иные и уровни ассоциаций.. короче, много скрытых весов. но, смешнее не это, а то, что возможно дело в том, что случайное число от 0 до 10 у ии 7, потому, что у человека это 7. в классическом исследовании Kubovy и Psotka (1976) примерно 28,4% из 1770 опрошенных выбирали 7 при просьбе назвать число от 0 до 9, а должно было бы 10% быть. а есть слой еще смешнее: https://aclanthology.org/2026.acl-long.1051/ но, в мозгах пока сложнее все, сильный семантический приор, потом конкурирующая история, где случайный ответ у кожаных подавляется и они начинают выпендриваться. если проще – чрезмерная присижн семантического приора к задаче, которая вообще не должна иметь (в идеале то) предпочтительного семантического решения. короче, тут нельзя сравнивать кожанный версус ии, т.к. ии суть отражение того, что у кожаных в голове. пока еще так. по мере обучения моделей на моделях... кто знает.
|